
Comprendre l'intelligence artificielle sans jargon ni approximation
Comment une machine apprend, pourquoi elle se trompe et ce qu'elle ne saura pas faire : l'intelligence artificielle expliquée sans jargon.

Tout le monde parle d'intelligence artificielle, peu de gens savent ce que fait la machine quand elle répond. Les définitions disponibles se ressemblent toutes : une technologie qui imite l'intelligence humaine, des réseaux de neurones inspirés du cerveau, quelques exemples du quotidien. C'est vrai, et cela n'aide à rien le jour où l'outil vous sort une réponse fausse avec un aplomb parfait. Cette page prend le problème par l'autre bout : ce que la machine calcule réellement, pourquoi elle se trompe, ce qu'elle ne saura pas faire, et comment vous en servir sans vous faire piéger.
Une IA n'est pas un logiciel comme les autres
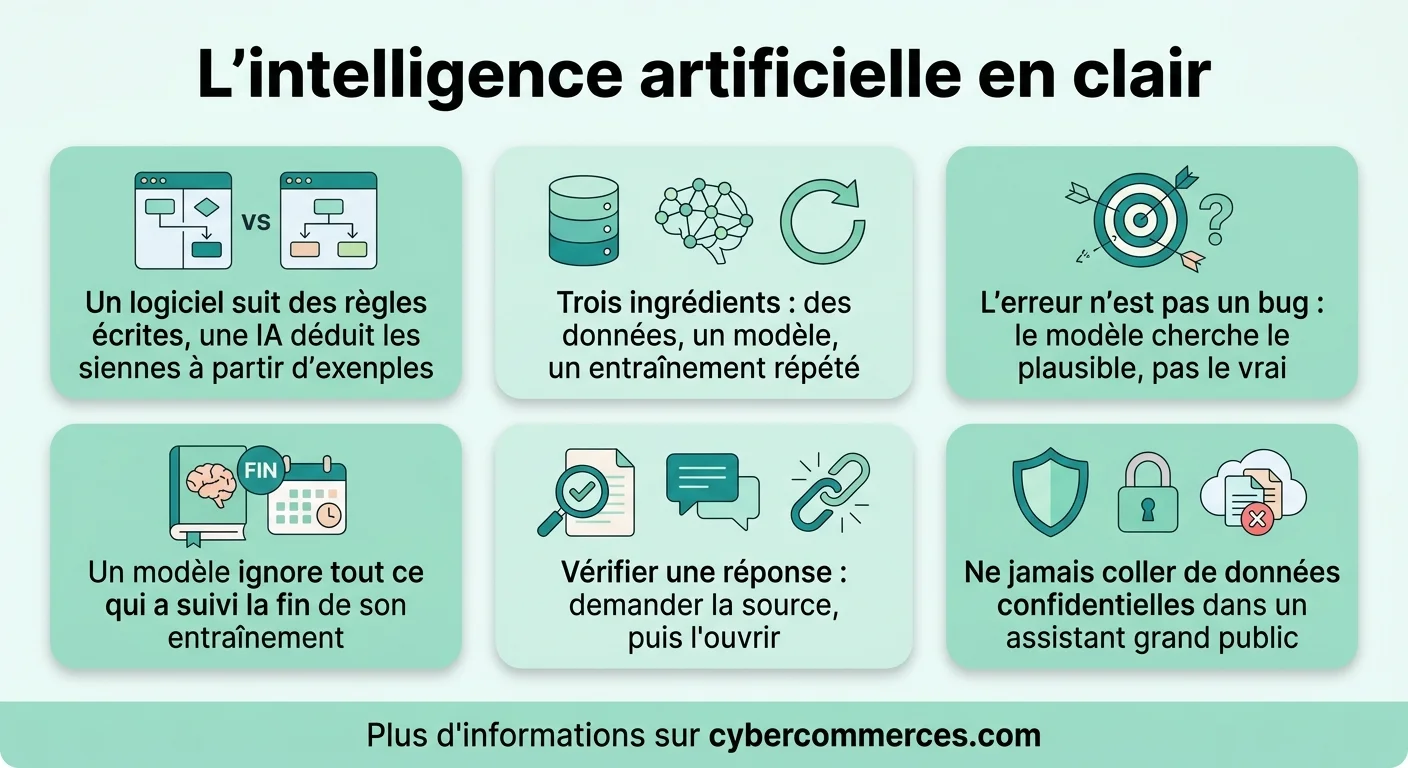
La différence tient en une phrase. Dans un logiciel classique, un humain a écrit toutes les règles : si le montant dépasse tel seuil, afficher tel message. Le programme ne fait rien d'autre que dérouler ces instructions, et son comportement est prévisible à la virgule près. Dans un système d'intelligence artificielle, personne n'a écrit les règles. On a montré à la machine des millions d'exemples, et elle en a déduit ses propres règles, que personne ne peut lire.
Cette nuance change tout en pratique. Un bug de logiciel classique se corrige : on trouve la ligne fautive, on la réécrit. Une erreur d'IA ne se corrige pas de cette façon, parce qu'aucune ligne ne dit explicitement ce qui a mal tourné. On peut seulement réentraîner le modèle avec d'autres exemples, en espérant que le comportement change dans le bon sens.
Un logiciel classique fait ce qu'on lui a dit de faire. Une IA fait ce qu'elle a déduit des exemples qu'on lui a montrés, ce qui n'est pas du tout la même garantie.
C'est aussi pour cette raison que deux personnes posant la même question à un même outil obtiennent parfois deux réponses différentes. Le résultat n'est pas gravé quelque part, il est recalculé à chaque fois, avec une part de variation volontairement introduite.
Comment une machine apprend : trois ingrédients, pas un de plus
L'apprentissage automatique se ramène à trois éléments. D'abord des données en très grande quantité, textes, images ou sons, chacune associée à ce qu'il faut en comprendre. Ensuite un modèle, c'est-à-dire une énorme formule mathématique comportant des millions ou des milliards de paramètres réglables. Enfin l'entraînement : on fait passer les données dans la formule, on compare la sortie à la bonne réponse, et on ajuste très légèrement les paramètres pour réduire l'écart. Puis on recommence, des milliards de fois.
L'expression « réseau de neurones » désigne simplement la façon dont cette formule est organisée en couches successives. La comparaison avec le cerveau humain, reprise partout, est une image très lointaine qui égare plus qu'elle n'éclaire : il n'y a aucune conscience, aucune compréhension, aucune intention derrière ces calculs, seulement des multiplications entre des nombres.
Une conséquence mérite d'être retenue : un modèle ne connaît que ce qu'il a vu pendant son entraînement, arrêté à une date donnée. Tout ce qui s'est passé après lui est inconnu, sauf si l'outil va chercher l'information ailleurs au moment de répondre, ce que font désormais certains assistants mais pas tous.
Pourquoi une IA se trompe, et pourquoi ce n'est pas un bug
Un modèle de langage ne cherche pas la vérité, il cherche la suite la plus plausible. Quand il ne dispose pas de l'information, il produit tout de même une suite plausible, c'est-à-dire une réponse qui a l'allure d'une bonne réponse. C'est ce qu'on appelle une hallucination, et ce n'est pas une défaillance : c'est le fonctionnement normal d'un système entraîné à ressembler, jamais à vérifier. Un nom d'auteur inventé, une référence légale qui n'existe pas ou une date décalée d'un an en sont les formes les plus courantes.
Les familles d'IA que vous croisez tous les jours
Parler de « l'IA » au singulier entretient la confusion, car les technologies regroupées sous ce mot n'ont ni les mêmes usages ni les mêmes risques. Voici celles que vous utilisez sans forcément les nommer, avec ce qu'elles font vraiment.
| Famille | Ce qu'elle fait | Où vous la croisez |
|---|---|---|
| Classification | Ranger un élément dans une catégorie | Filtre antispam, tri de photos |
| Recommandation | Prédire ce qui vous plaira | Boutiques en ligne, plateformes vidéo |
| Reconnaissance | Identifier un motif dans une image ou un son | Déverrouillage facial, dictée vocale |
| Prévision | Estimer une valeur future | Trajets et temps de parcours, météo |
| Génération | Produire un texte ou une image inédite | Assistants conversationnels |
Les quatre premières familles existent depuis des années et fonctionnent en arrière-plan, sans que personne s'en émeuve. Seule la dernière, la génération, a rendu l'IA visible du grand public, et c'est elle qui pose les questions les plus neuves.
Cette distinction n'a rien d'académique, car le risque n'est pas le même d'une famille à l'autre. Quand un filtre antispam se trompe, vous perdez un courrier et vous le voyez tout de suite. Quand un moteur de recommandation se trompe, on vous propose un film qui ne vous plaît pas, sans autre conséquence. La génération de texte est la seule famille où l'erreur est invisible par construction, puisque le résultat a exactement la même apparence qu'il soit juste ou faux. C'est aussi la seule où vous fournissez vous-même des informations à la machine pour obtenir votre réponse.
L'IA générative : ce qui a réellement changé depuis 2022
L'arrivée des assistants conversationnels grand public à la fin de l'année 2022 n'a pas marqué une rupture scientifique. Les mécanismes employés étaient connus des chercheurs depuis plusieurs années. Ce qui a changé, c'est l'échelle : des modèles beaucoup plus gros, entraînés sur beaucoup plus de textes, et surtout une interface où n'importe qui peut écrire une question en français courant.
Ce déplacement a une conséquence sous-estimée. Auparavant, l'IA rendait un service invisible et vérifiable par son résultat : le trajet proposé était bon ou mauvais, on le constatait immédiatement. Désormais elle produit du texte, dont la qualité ne se constate pas : un paragraphe faux se lit exactement comme un paragraphe juste, avec la même syntaxe assurée.
C'est pourquoi la question de la vérification est devenue centrale en trois ans, alors qu'elle ne se posait pratiquement pas avant. L'Union européenne a d'ailleurs adopté en 2024 un règlement sur l'intelligence artificielle, dont l'application s'échelonne jusqu'en 2027, qui impose notamment de signaler les contenus générés par une machine.
Ce qu'une IA ne sait pas faire, et ne saura pas faire demain
Trois limites tiennent à la nature même de ces systèmes, et aucune version plus puissante ne les fera disparaître. La première est qu'un modèle ne sait pas qu'il ne sait pas. Rien dans son fonctionnement ne distingue une réponse solidement étayée d'une reconstitution plausible, ce qui explique l'assurance identique dans les deux cas.
La deuxième est l'absence d'expérience du monde. Un modèle a lu des descriptions de la pluie, il n'a jamais été mouillé. Sur tout ce qui suppose de savoir comment les choses se comportent réellement, ses réponses sont des reconstitutions à partir de textes, pas des constats.
Une IA vous donnera toujours une réponse. C'est précisément pour cela qu'il ne faut jamais confondre obtenir une réponse et obtenir la bonne.
La troisième limite est la dépendance aux données d'entraînement. Un modèle nourri de textes majoritairement anglophones raisonne moins bien sur le droit français ; un modèle entraîné sur des données déséquilibrées reproduira ce déséquilibre, sans que personne l'ait voulu. C'est le mécanisme des biais, et il ne se règle pas par une consigne mais par un travail sur les données elles-mêmes.
Le coût réel : des puces, de l'électricité et de l'eau
Cette partie de l'histoire est rarement racontée par les entreprises qui vendent ces outils. Entraîner un grand modèle mobilise pendant des semaines des milliers de processeurs graphiques spécialisés, un matériel informatique dont la production est concentrée chez très peu de fabricants dans le monde. Cette rareté explique une bonne part des tensions industrielles observées ces dernières années.
L'entraînement n'est pourtant pas le plus lourd sur la durée. Chaque question posée déclenche un calcul, et multiplié par des centaines de millions d'utilisateurs quotidiens, l'usage courant finit par peser davantage que la phase d'apprentissage. D'où la construction de centres de données de plus en plus vastes, gros consommateurs d'électricité et d'eau de refroidissement.
Retenir cet ordre de grandeur a une utilité concrète : cela explique pourquoi les versions les plus performantes sont payantes, pourquoi les réponses sont parfois volontairement raccourcies aux heures de pointe, et pourquoi les fournisseurs poussent tant vers des modèles plus petits, moins gourmands et souvent suffisants. Cela relativise aussi une idée répandue selon laquelle une requête à une IA coûterait autant qu'une recherche classique : l'écart existe bel et bien, il varie selon le modèle interrogé, et il justifie de réserver les modèles les plus lourds aux questions qui le méritent vraiment.
Ce que deviennent les données que vous saisissez
Question rarement traitée par les éditeurs, pour une raison évidente : ils sont juges et parties. Lorsque vous écrivez dans un assistant, votre texte part sur les serveurs du fournisseur, y est conservé un certain temps, et peut selon les conditions d'utilisation servir à améliorer le modèle. Le principe de la sécurité des systèmes d'information s'applique ici comme ailleurs : ce qui sort de chez vous ne vous appartient plus vraiment.
La conséquence pratique est simple à retenir. Ne collez jamais dans un assistant grand public un contrat non public, des données de santé, des coordonnées bancaires ou un fichier de clients. Non pas parce que le fournisseur serait malveillant, mais parce que vous perdez la maîtrise de ces informations et, dans un cadre professionnel, vous engagez la responsabilité de votre employeur.
La CNIL a publié plusieurs séries de recommandations sur ce point, et la plupart des grands outils proposent désormais un réglage permettant d'exclure vos échanges de l'entraînement. Il est presque toujours désactivé par défaut : cinq minutes dans les paramètres du compte règlent la question une fois pour toutes.
L'IA dans les objets qui vous entourent déjà
Le débat public se concentre sur les assistants conversationnels, alors que l'essentiel de l'intelligence artificielle déployée aujourd'hui se trouve dans des objets ordinaires. Votre téléphone reconnaît votre visage, débruite vos photos de nuit et prédit le mot suivant quand vous écrivez, trois fonctions bâties sur des modèles entraînés. Aucune n'est présentée comme de l'IA, ce qui n'y change rien.
Le mouvement s'étend à l'ensemble des appareils communicants, comme le montrent les chiffres du marché des objets connectés. Thermostat qui apprend vos horaires, montre qui détecte une chute, aspirateur qui cartographie un logement : dans chaque cas, un modèle a été entraîné sur des milliers de situations comparables.
Une évolution mérite l'attention, celle du calcul effectué directement dans l'appareil plutôt que sur un serveur distant. Elle améliore la réactivité, fonctionne sans connexion et surtout limite ce qui sort de chez vous. Quand un fabricant précise que le traitement est réalisé sur l'appareil, ce n'est pas un argument marketing creux, c'est une différence réelle en matière de confidentialité.
Les réflexes qui changent tout à l'usage
Se servir correctement d'une IA relève moins de la technique que de quelques habitudes, qui tiennent en un tableau. Elles ne demandent aucune connaissance particulière et suffisent à éviter la grande majorité des mauvaises surprises.
| Situation | Le réflexe | Pourquoi |
|---|---|---|
| Recherche d'un fait précis | Demander la source, puis l'ouvrir | La référence peut être inventée |
| Sujet d'actualité | Vérifier la date de connaissance du modèle | L'entraînement s'arrête à une date |
| Document sensible | Anonymiser avant de coller | Le texte quitte votre poste |
| Réponse très assurée | Redemander en formulant autrement | Une variation révèle l'incertitude |
Le dernier réflexe est le plus utile et le moins connu. Poser deux fois la même question sous deux formulations différentes est un test de solidité redoutable : sur un fait bien établi, les deux réponses concordent ; sur une reconstitution hasardeuse, elles divergent souvent, et cette divergence vous renseigne davantage que n'importe quelle explication de l'outil sur son propre fonctionnement.
Questions fréquentes
Quelle est la définition simple de l'intelligence artificielle ?
C'est un ensemble de techniques permettant à une machine de déduire ses propres règles à partir d'exemples, au lieu de suivre des règles écrites par un humain. La différence avec un logiciel ordinaire tient entièrement là. L'expression a été forgée en 1956 lors d'une conférence universitaire à Dartmouth, aux États-Unis, et couvre depuis des technologies très différentes les unes des autres, du filtre antispam à l'assistant conversationnel.
Comment fonctionne concrètement l'intelligence artificielle ?
Par ajustements successifs. On fait passer des millions d'exemples dans une formule mathématique géante, on compare le résultat obtenu à la bonne réponse, et on modifie très légèrement les paramètres de la formule pour réduire l'écart. Répétée des milliards de fois, l'opération finit par produire un modèle capable de traiter des cas qu'il n'a jamais vus. Aucune compréhension n'intervient, uniquement du calcul.
Quels sont les principaux risques de l'intelligence artificielle ?
Pour un usage courant, trois risques dominent nettement les autres. L'erreur affirmée avec assurance, d'abord, qui passe d'autant plus facilement que le texte est bien écrit. La fuite de données ensuite, quand des informations confidentielles sont saisies dans un outil grand public. Les biais enfin, qui reproduisent dans les réponses les déséquilibres présents dans les données d'entraînement, souvent sans que personne le remarque.
L'intelligence artificielle peut-elle devenir consciente ?
Rien dans les systèmes actuels ne va dans cette direction, et il faut distinguer deux choses. Un modèle de langage sait produire un texte qui parle de conscience de façon convaincante, parce qu'il a lu des milliers de textes sur le sujet. Cela ne dit strictement rien de son état interne, qui se résume à des opérations arithmétiques. La question reste ouverte sur le plan philosophique, elle ne l'est pas sur le plan technique.
Faut-il payer pour utiliser une IA correctement ?
Pas nécessairement, mais les différences sont réelles. Les versions gratuites reposent le plus souvent sur des modèles plus légers, avec une date de connaissance plus ancienne et un accès limité à la recherche en ligne. Pour un usage occasionnel, cela suffit largement à condition de vérifier les faits. Pour un usage professionnel régulier, la version payante se justifie surtout par les garanties de confidentialité qu'elle apporte sur les données saisies.
Comment savoir si un texte a été écrit par une intelligence artificielle ?
Aucun outil de détection n'est fiable, et il vaut mieux le savoir avant de se fier à l'un d'eux : les faux positifs sur des textes humains sont fréquents. Les indices restent humains, un propos très lisse qui n'engage jamais rien, des exemples génériques, une absence totale de détail vérifiable. Le règlement européen impose désormais le signalement des contenus générés, ce qui reste la voie la plus fiable à terme.